Der blinde Fleck bei der KI-Erkennung
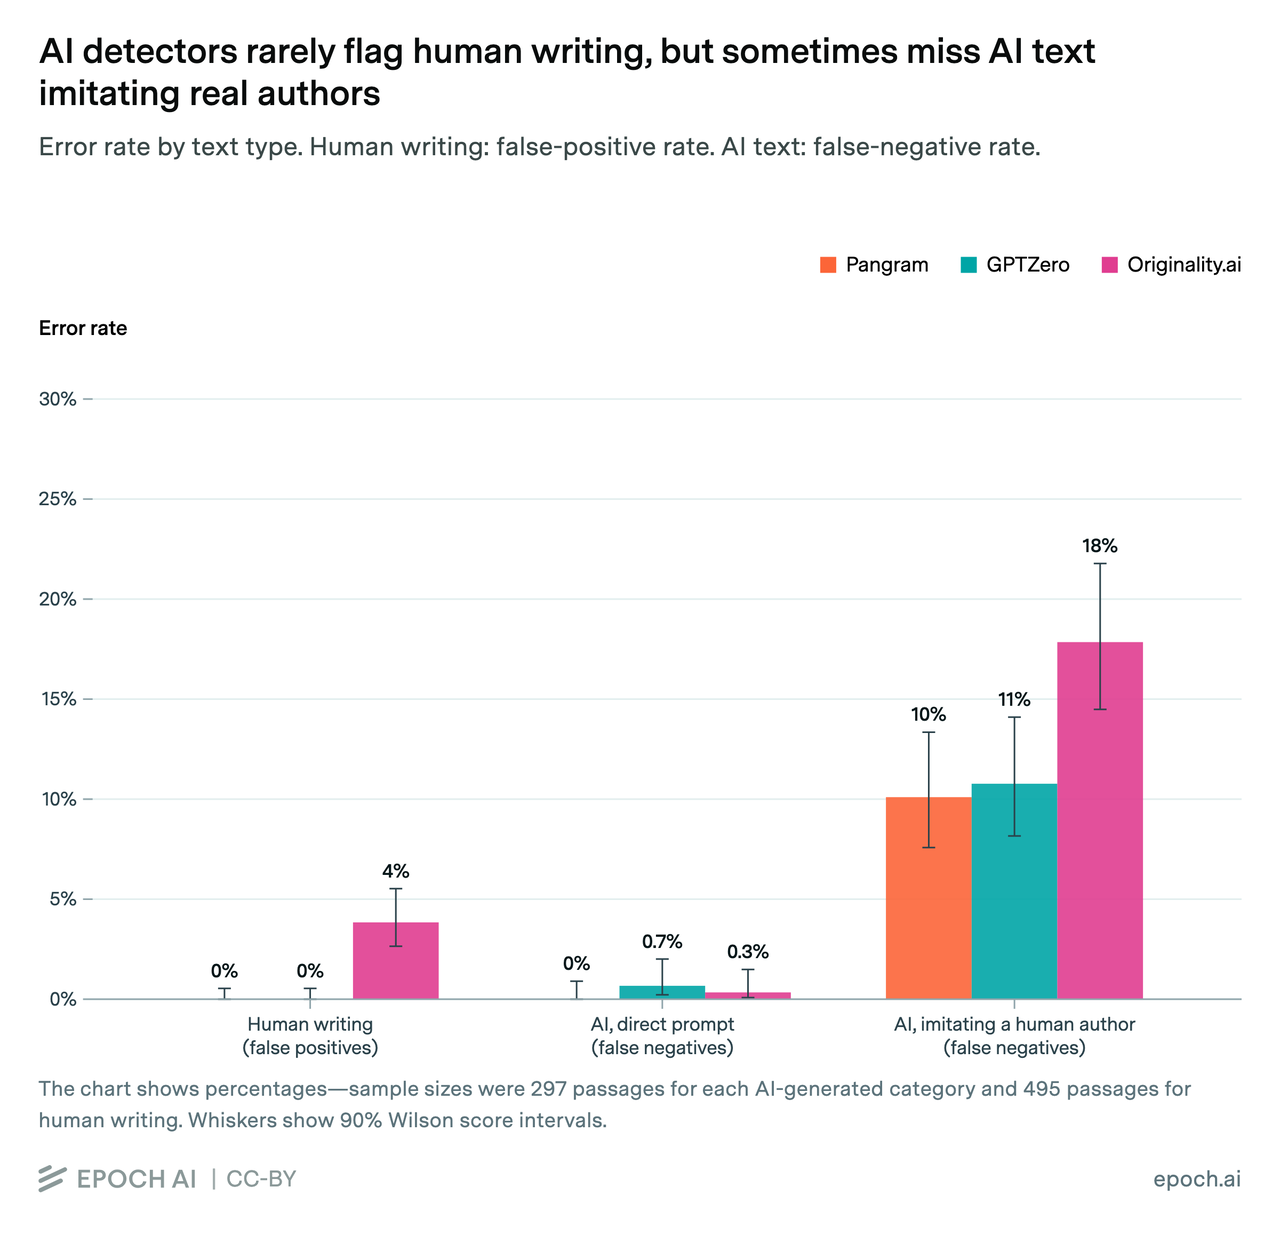
KI-Detektoren kennzeichnen menschliche Texte nur selten als KI-Text, übersehen jedoch manchmal KI-generierte Texte, die dem Schreibstil echter Autoren sehr ähnlich sind.
Da generative KI-Modelle immer ausgefeilter werden, setzen Verlage aus den Bereichen Fachliteratur, Wissenschaft und Journalismus zunehmend auf automatisierte KI-Detektoren als primären Filter gegen nicht als solche gekennzeichnete, maschinell erzeugte Manuskripte. Allerdings ist ein Auswertung durch das Forschungsunternehmen Epoch AI (Juli 2026, von Jaeho Lee) Dies offenbart eine grundlegende Schwachstelle dieser Tools: Während Detektoren zwar manchmal hervorragend darin sind, generische KI-Ergebnisse zu erkennen, versagen sie regelmäßig, wenn Modelle angewiesen werden, den Stil eines bestimmten Autors nachzuahmen.
Veröffentlicht: 28.7.2026 | Foto / Video: KI-generiert, Magnific | KI-generierte Übersetzung des Originalartikels
Für Führungskräfte im Verlagswesen, Chefredakteure und Koordinatoren von Peer-Review-Verfahren zeigt die Studie entscheidende Einschränkungen in den derzeitigen Überprüfungsabläufen auf – insbesondere im Bereich des wissenschaftlichen und akademischen Verlagswesens.
Die wichtigsten Ergebnisse auf einen Blick
Direkte KI-Eingabeaufforderungen lassen sich leicht erkennen: Wenn Modelle anhand einfacher Anweisungen Text generieren (z. B. „Schreibe eine Kurzgeschichte über einen verlorenen Hund“), sind die Erkennungsraten nahezu perfekt – die Falsch-Negativ-Rate lag über alle getesteten Plattformen hinweg im Durchschnitt unter 1 %.
Die Stilimitation führt zu einer Erkennungslücke von ca. 13 %: Als den State-of-the-Art-Modellen (Claude Opus 4.8, GPT-5.5, Gemini 3.1 Pro) lediglich fünf Beispielpassagen aus dem Werk eines Autors zur Verfügung gestellt wurden, konnten die Erkennungsprogramme den daraus resultierenden KI-Text in etwa jedem achten Fall nicht als solchen identifizieren (Umgehungsraten von 10 % bis 18 %).
Das wissenschaftliche Publizieren ist dem höchsten Risiko ausgesetzt: Wissenschaftliche Texte, deren Stil imitiert wurde, entgingen in 24 % bis 29 % der Fälle auf allen drei großen Plattformen der Erkennung, wobei die Fehlerquote bei bestimmten Kombinationen aus Modell und Detektor einen Höchstwert von 48 % erreichte.
Die Zahl der Fehlalarme bleibt gering (mit einer bemerkenswerten Ausnahme): Pangram und GPTZero stuften 0 % der tatsächlich von Menschen verfassten Texte als KI-Text ein, während Originality.ai 3,8 % der von Menschen verfassten Textpassagen wurden falsch identifiziert – bei von Menschen verfassten Belletristiktexten waren es sogar 10 %.
Die fehlerhafte Einstufung der digitalen Urheberschaft
Warum man manchen KI-Detektoren nicht trauen kann | Die Authors Guild hat fünf davon auf Herz und Nieren geprüft
Wie in der Studie die führenden Erkennungsprogramme getestet wurden
Im Rahmen des Epoch-AI-Vergleichstests wurden drei weit verbreitete Erkennungsplattformen mit den aktuellsten Versionen ihrer Engines einem Benchmark-Test unterzogen:
Pangram (v3.3.2): Ein neuronaler Klassifikator, der mithilfe umfangreicher „Hard-Negative-Mining“-Verfahren trainiert wurde, um die Anzahl der falsch-positiven Ergebnisse gegen Null zu senken.
GPTZero (Modell 2026-05-11-base): Ein Detektor, der auf „Perplexität“ (Vorhersehbarkeit der Wortwahl) und „Burstiness“ (Variation in der Satzstruktur und Vorhersehbarkeit) basiert.
Originality.ai (Turbo 3.0.2): Ein überwachter Klassifikator, der anhand umfangreicher Datensätze mit beschrifteten, von Menschen und Maschinen verfassten Texten trainiert wurde.
Der Basisdatensatz mit menschlichen Texten umfasste 495 Textabschnitte (jeweils ca. 500 Wörter) von 99 Autoren aus drei Genres: Blogbeiträge, Belletristik und wissenschaftliche Texte (die wissenschaftlichen Texte stammten aus arXiv-Publikationen vor 2022; Blogbeiträge und Belletristik aus Wayback-Machine-Snapshots vor 2022, die alle aus der Zeit vor ChatGPT stammten, um eine Beeinflussung durch KI auszuschließen). Dieser wurde mit 297 KI-generierten Textabschnitten pro Bedingung (insgesamt 594) unter zwei unterschiedlichen Prompt-Bedingungen verglichen: generische Themen-Prompts und Stilimitation mit fünf Beispielen.
Aufschlüsselung der Leistung nach Genres und Tools
Bei einer Aufschlüsselung der falsch-negativen Ergebnisse nach Genre zeigt sich eine deutliche Diskrepanz. Während Unterhaltungsliteratur und allgemeine Blogbeiträge für die Erkennungsalgorithmen nach wie vor relativ leicht zu identifizieren sind, führt Fachprosa zu einer erheblichen Verschlechterung der Erkennungsgenauigkeit.
Belletristik: 1 % (Pangram) | 2 % (GPTZero) | 5 % (Originality.ai)
Bloggen: 4 % (Pangram) | 6 % (GPTZero) | 19 % (Originality.ai)
Wissenschaftliches Schreiben: 25 % (Pangram) | 24 % (GPTZero) | 29 % (Originality.ai)
Der Grund für dieses Scheitern liegt in der Natur des wissenschaftlichen Schreibens. Wissenschaftliche Artikel zeichnen sich durch den intensiven Einsatz standardisierter Passivkonstruktionen, fachspezifischer Terminologie und stark strukturierter, vorhersehbarer Formulierungen aus. Wenn ein KI-Modell angewiesen wird, die früheren Arbeiten eines Forschers nachzuahmen, entspricht seine strukturelle Ausgabe weitgehend der anerkannten wissenschaftlichen Schreibweise, wodurch die statistische Zufälligkeit („Burstiness“) neutralisiert wird, auf die Erkennungsalgorithmen angewiesen sind.
Taktische Implikationen für Führungskräfte im Verlagswesen
1. Die automatisierte Sichtung von Manuskripten aus dem „Slush Pile“ und die Begutachtung durch Fachkollegen neu bewerten
Die Werte ohne falsch-positive Ergebnisse bei Pangram und GPTZero deuten darauf hin, dass eine positive KI-Kennzeichnung bei Standardprosa äußerst zuverlässig ist. Ein negatives Ergebnis ist jedoch kein Beweis für menschlichen Ursprung. Redaktionsteams, die automatisierte Tools zum Filtern von Einsendungen verwenden, müssen einen „sauberen“ Bericht als grundlegende Überprüfung betrachten und nicht als Garantie für die Originalität des Textes.
2. Vorbereitung auf gezielte Fragen zum Autorenprofil
Da sich die Anwendungsbereiche der KI immer weiter ausdehnen, können böswillige Mitwirkende oder Ghostwriter die bisherigen Veröffentlichungen eines Autors oder bereits veröffentlichte Artikel problemlos in eine Modell-Eingabe einspeisen, bevor sie ein Manuskript generieren. Daten von Epoch AI zeigen, dass diese einfache Technik in etwa einem Viertel bis fast einem Drittel der Fälle (24 % bis 29 %, je nach Detektor) im wissenschaftlichen Verlagswesen automatisierte Filter umgeht.
3. Risiken von Fehlalarmen bei kreativen Abdrücken minimieren
Originality.aiDie Falsch-Positiv-Rate von 10 % bei echten, vor 2022 verfassten literarischen Werken verdeutlicht die rechtlichen und ethischen Risiken automatisierter Richtlinien, die Werke bei Erkennung automatisch ablehnen. Die ungerechtfertigte Anschuldigung von Autoren, KI ohne Genehmigung eingesetzt zu haben, birgt die Gefahr, die Beziehungen zu den Autoren zu beeinträchtigen, öffentliche Kritik hervorzurufen und vertragliche Streitigkeiten auszulösen.
Praktische Schritte zur Umsetzung
1. Einführung eines hybriden Verifizierungsmodells: Kombinieren Sie automatisierte Software mit redaktioneller Kontrolle durch Menschen, Überprüfungen der kontextuellen Konsistenz und der Überprüfung der Herkunft der Autoren (z. B. anhand von Änderungshistorien, Arbeitsentwürfen oder Rohnotizen aus der Recherche).
2. Festlegung klarer Standards für die Offenlegung von Autorenangaben: Führen Sie Richtlinien ein, die zulässige Verwendungszwecke von KI-Tools (z. B. Korrekturlesen, Unterstützung beim Programmieren, redaktionelle Bearbeitung) von unzulässigen Verwendungszwecken (z. B. Erstellung von Texten ohne Quellenangabe) abgrenzen und so Transparenz gegenüber verdeckten Umgehungsstrategien fördern.
3. Anpass der Bewertungsprotokolle nach Abteilung: Abteilungen für wissenschaftliche, medizinische und STM-Fachzeitschriften sollten strengere Standards bei der Überprüfung von Einreichungen anwenden als Belletristik- oder Sachbuchverlage, um der Fehlerquote von etwa 25 % und mehr bei technischen Texten Rechnung zu tragen.