Die Verlagsbranche führt den falschen KI-Krieg
„The Publishing Pulse“: Sebastian Mayeres erklärt, warum Vertrauen und redaktionelles Urteilsvermögen zum entscheidenden Wettbewerbsvorteil werden.
Veröffentlicht: 1.10.2026 | Foto / Video: KI-generiert, Magnific | KI-generierte Übersetzung des englischen Original-Artikels (Claude)
Ein Buchdeal über zwei Millionen Dollar ist kürzlich geplatzt, weil niemand eine Frage beantworten konnte, die im Verlagswesen eigentlich zu den einfachsten gehört: Wer hat das Buch geschrieben?
Jerry Falades Krimidebüt „Call Me, I'll Hide the Body“ hatte großes Interesse geweckt. Seine Agenten zogen das Manuskript schließlich zurück. Sie begründeten das damit, dass sie nicht mehr sicherstellen könnten, dass es vollständig von ihrem Klienten stamme. Falade bestreitet entschieden, KI eingesetzt zu haben, und wehrt sich gegen die Vorwürfe.
Mich interessiert hier weniger, ob Falade KI genutzt hat oder nicht. Viel spannender finde ich, dass die Verlagsbranche plötzlich eine Frage nicht beantworten kann, für die bis vor Kurzem niemand eine nennenswerte Infrastruktur für nötig gehalten hätte.
Ein Autor schrieb ein Manuskript. Ein Agent vertrat es. Ein Verlag kaufte es ein. Es gab eine Vertrauenskette. Oder besser gesagt: Es gab schon immer eine Vertrauenskette. Wir mussten uns bloß nie ernsthaft Gedanken darüber machen, wie man belegt, was geschehen war, bevor das Manuskript auf irgendeinem Schreibtisch landete.
Generative KI ändert das. Und ich frage mich zunehmend, ob die Branche darauf reagiert, indem sie die falsche Schlacht schlägt.
Die Frage, ob KI im Spiel war, geht zunehmend am Kern vorbei
Wurde KI eingesetzt? Das scheint die Frage zu sein, auf die alle eine Antwort wollen.
Wurde das Manuskript mit KI generiert? Wie viel KI ist zu viel? Sollten Autoren den Einsatz offenlegen? Können wir ihn erkennen? Sollten Bücher ein Label „von Menschen geschrieben“ tragen?
Das Wall Street Journal beschrieb kürzlich eine Branche, die genau mit diesen Fragen ringt. Die Beispiele reichen von geplatzten Buchdeals über Agenten, die Einsendungen erhalten, die sie für KI-generiert halten, bis zu Verlagen, die herauszufinden versuchen, wo Unterstützung endet und Urheberschaft beginnt. Auch KI-Detektoren werden in diese Debatte hineingezogen, obwohl auf der Hand liegt, dass ein Fehlurteil für einen Autor gravierende Folgen haben kann.
Was aber, wenn „Wurde KI eingesetzt?“ schon jetzt die falsche Frage ist?
Nehmen wir Allison Stanger, Professorin und Autorin. Sie schrieb kürzlich im Wall Street Journal, KI mache sie zu einer besseren Autorin. Sie lässt die Maschine nicht für sich denken. Argumentation, Aufbau, Erinnerungen, Urteil und Stimme bleiben ihre eigenen.
Aber sie nutzt KI als Gegenleserin, die gezielt widerspricht. Sie lässt sie ihre Belege infrage stellen, schwache Übergänge aufspüren und die Gegenposition vertreten. Sie setzt sie für mechanische Arbeiten ein. Beim Faktencheck für ihr demnächst erscheinendes Buch hat sie sogar zwei KI-Systeme genutzt und deren Hinweise selbst anhand ihrer Originalquellen überprüft.
Ist das ein von KI geschriebenes Buch? Ich finde nicht. Aber KI war eindeutig an seiner Entstehung beteiligt. Und hier eine saubere Grenze zu ziehen, wird schwieriger, nicht leichter.
Eine Flut billiger Inhalte wird den Markt allein durch schiere Masse umkrempeln
Es gibt noch einen weiteren Grund, warum wir uns meiner Meinung nach auf das Falsche konzentrieren. KI-generierte Bücher müssen gar nicht besser werden als von Menschen geschriebene, um den Buchmarkt aufzumischen. Es reicht, wenn es sie massenhaft gibt.
Eine Studie untersuchte Selfpublishing-Titel aus der Genreliteratur, die bei Amazon verkauft werden. Sie zeigte, dass sich Bücher mit einem erheblichen Anteil KI-generierten Texts pro Titel in der Regel schlechter verkauften. Dennoch erreichen diese Bücher eine beachtliche kommerzielle Größenordnung. Ihr Anteil an den Verkäufen wächst, und sie besetzen immer mehr der knappen Spitzenplätze in den Rankings.
Noch aufschlussreicher ist Folgendes. Die Zahl der Titel, die pro Quartal überhaupt Verkäufe verzeichneten, stieg drastisch, während der Gesamtumsatz pro Quartal deutlich langsamer wuchs. Wir bringen massiv mehr Bücher in einen Markt, in dem das Geld nicht annähernd im gleichen Tempo mitwächst.
Die Forscher beschreiben einen Markt, der eher durch Masse als durch Qualität umgekrempelt wird. Das ist für mich der eigentlich interessante Teil.
Jahrhundertelang kostete es erheblich Zeit, Können und Geld, ein Buch herzustellen. Diese Hürden waren gewiss keine Qualitätsgarantie. Wir haben schon lange vor ChatGPT jede Menge schlechte Bücher veröffentlicht. Aber sie sorgten für Reibung.
Generative KI beseitigt einen großen Teil dieser Reibung. Und wenn wir immer mehr Inhalte zu Grenzkosten nahe null erzeugen können, taugt das bloße Produzieren eines weiteren Inhalts immer weniger als Wettbewerbsvorteil.
Etwas anderes muss an Wert gewinnen.
Wir können nicht davon ausgehen, dass die Leser maschinell erstellte Bücher ablehnen werden
Hier wird die Diskussion unbequem. Was, wenn den Lesern manches davon tatsächlich gefällt?
Angenommen, jemand kauft einen KI-generierten Thriller, liest ihn gern bis zum Ende und will sofort den nächsten. Mit welcher Begründung erklären wir dieses Leseerlebnis dann für illegitim?
Das heißt nicht, dass Fragen zu Urheberrecht, Rechten, Autorschaft oder Vergütung damit erledigt wären. Natürlich nicht. Aber das Lesevergnügen wird diese Fragen auch nicht für uns lösen.
Die Verlagsbranche erzählt sich seit Jahrzehnten, ihr Zweck sei es, Inhalte zu finden und zu liefern, die Lesern etwas wert sind. Es wäre schon etwas merkwürdig, wenn wir plötzlich beschlössen, dass der Entstehungsprozess wichtiger ist als das Leseerlebnis, nur weil eine Maschine beteiligt war.
Und das ist keineswegs rein hypothetisch. Studien zu KI-generierten literarischen Textauszügen haben bereits gezeigt, dass Leser KI-Texte unter bestimmten Bedingungen genauso gut oder sogar besser bewerten als Texte erfahrener menschlicher Autoren.
Das heißt nicht, dass ChatGPT plötzlich das nächste „Krieg und Frieden“ schreiben kann. Es heißt auch nicht, dass Autoren überflüssig sind. Und wir sollten vorsichtig sein, aus ein paar Kurzgeschichten auf den gesamten Buchmarkt zu schließen.
Aber es sollte uns davor bewahren, vorschnell anzunehmen, Leser würden maschinell erzeugte Werke automatisch ablehnen, sobald diese gut genug sind. Ich glaube nicht, dass sich die Zukunft sauber aufteilen lässt in: Bücher von Menschen = gut, KI-Bücher = schlecht. Das wäre herrlich einfach. Ich glaube nur nicht, dass es so laufen wird.
Verlage sollten auf klare Verantwortung setzen statt auf prozentuale Reinheitsgrade
Stellen Sie sich ein KI-gestütztes Buch vor, das Leser wirklich lieben. Großartig. Das sagt etwas über seine Qualität. Es sagt uns aber nicht, wer dafür verantwortlich ist, ob die zugrunde liegenden Rechte geklärt sind, ob Tatsachenbehauptungen geprüft wurden oder ob fremde Werke auf unzulässige Weise wiedergegeben wurden.
Hinter all dem muss nach wie vor jemand stehen. Und genau hier wird die Rolle des Verlags richtig interessant.
Ich glaube nicht, dass Verlage ein perfektes System brauchen, das ihnen sagt, ob ein Manuskript zu 7, 28 oder 63 Prozent KI-generiert ist. Selbst wenn so etwas technisch möglich würde, bin ich nicht überzeugt, dass die Zahl an sich besonders nützlich wäre.
Nehmen wir noch einmal Allison Stanger. Sie lässt KI ihre Argumente hinterfragen, Schwächen aufdecken und beim Faktencheck helfen. Wie viel des Buches ist dann KI? Fünf Prozent? Zwanzig Prozent? Null Prozent?
Ich habe keine Ahnung. Und, wichtiger noch: Ich bin nicht sicher, ob mich das interessiert.
Dasselbe Problem stellt sich schnell, sobald wir über das Schreiben hinausgehen. Was ist mit Übersetzung, Recherche, Lektorat, Brainstorming oder Faktencheck? Irgendwann laufen wir Gefahr, einen sehr aufwendigen Compliance-Prozess um eine Zahl herum zu bauen, die uns gar nicht sagt, ob das Werk gut, rechtlich sauber oder vertrauenswürdig ist.
Vielleicht ist die bessere Frage also viel einfacher: Wer übernimmt die Verantwortung für dieses Werk?
Eine lückenlose Herkunftskette zählt mehr als KI-Lügendetektoren
Ein Autor kann KI intensiv genutzt haben und trotzdem bereit sein zu sagen: Das sind meine Ideen, ich habe die Entscheidungen getroffen, ich habe die Aussagen geprüft, ich besitze die nötigen Rechte, ich gebe das fertige Werk frei und stehe dafür ein. Das halte ich für weit aussagekräftiger als ein Häkchen bei „Keine KI verwendet“.
Fred Zimmerman bringt hier ein interessantes Argument vor. Statt immer bessere KI-Lügendetektoren zu bauen, schlägt er vor, eher in Kategorien einer „Chain of Custody“ zu denken, also einer lückenlosen Herkunftskette. Dabei geht es darum zu verstehen, wer an einer Fassung gearbeitet hat, welche Werkzeuge verwendet wurden und wer was tun durfte.
Das gefällt mir, weil es eine eher philosophische KI-Debatte in etwas verwandelt, mit dem Verlage tatsächlich arbeiten können. Wir brauchen keine forensische Rekonstruktion dessen, was ein Autor an einem verregneten Dienstag um 15:17 Uhr beim Umschreiben von Kapitel sieben getan hat. Aber Verlage müssen vermutlich genug wissen, um zu verstehen, was sie veröffentlichen und wo die Risiken liegen.
Lange Zeit vermittelte das Logo eines Verlags stillschweigend so etwas wie: Wir haben das ausgewählt.
In einem mit KI-Inhalten überfluteten Markt muss diese Aussage vielleicht mehr bedeuten: Wir wissen, woher das stammt. Wir verstehen, wie es entstanden ist. Wir sind überzeugt, dass die Rechte geklärt sind. Wir haben geprüft, was geprüft werden musste. Und wir sind bereit, mit unserem Namen dafür einzustehen.
Ich zögere ein wenig, das einen „Trust Layer“ zu nennen, weil es verdächtig nach etwas klingt, das Berater auf eine PowerPoint-Folie schreiben würden. Aber der Gedanke lässt mich nicht los.
Informationen vertrauenswürdig zu machen, eröffnet große neue Umsatzchancen
Ich möchte nicht, dass daraus wieder eine Diskussion darüber wird, wie KI den Verlagen zusätzliche Compliance-Arbeit aufbürdet. Darin steckt auch eine geschäftliche Chance.
Wiley meldete für sein jüngstes Geschäftsjahr 49 Millionen US-Dollar Umsatz mit KI und Datenanalyse. McGraw Hill bedient inzwischen mehr als 7,5 Millionen aktive Nutzer mit acht KI-gestützten Lernwerkzeugen. Diese Geschäfte unterscheiden sich natürlich deutlich vom Publikumsverlag, und nicht jeder Verlag kann einfach nachmachen, was sie tun. Aber das Signal ist interessant.
Sie nehmen Dinge, die Verlage ohnehin besitzen oder gut verstehen, also Inhalte, Rechte, strukturierte Informationen, Daten und Fachexpertise. Und sie machen sie nützlicher in einer Welt, in der generische Inhalte billig zu erzeugen sind.
Vielleicht werden auch Verlagsmarken Teil dieser Gleichung.
Die meisten Leser könnten vermutlich nicht sagen, in welchem Verlag die letzten fünf Bücher erschienen sind, die sie gekauft haben. Und vielleicht ändert KI daran nichts. Aber wenn zehn- oder zwanzigmal so viele Inhalte um meine Aufmerksamkeit konkurrieren, werden Signale wertvoller, denen ich vertraue.
Dieses Signal kann von einem Autor, einem Rezensenten, einer Community oder vielleicht auch wieder von einem Verlag kommen. Das liegt nicht daran, dass der Verlag den Marktzugang kontrolliert, diese Zeiten sind vorbei. Es liegt daran, dass jemand Glaubwürdiges das Werk ausgewählt hat, weiß, woher es stammt, und bereit ist, dafür einzustehen.
Wenn Inhalte grenzenlos werden, gewinnt menschliches Urteil an Wert
Seit Jahren lautet die Technologiefrage im Verlagswesen ungefähr so: Was passiert, wenn Autoren keine Verlage mehr brauchen, weil Technologie es ihnen erlaubt, Bücher selbst zu schreiben, herzustellen und zu vertreiben?
KI treibt uns zweifellos weiter in diese Richtung. Aber die Geschichte hat auch eine andere Seite. Was, wenn glaubwürdiges Urteil umso wertvoller wird, je mehr Inhalte die Technologie hervorbringt?
Wenn wir morgen 10.000 neue Thriller erzeugen können, ist Thriller Nummer 10.001 keine besondere Leistung. Zu wissen, welche drei davon wirklich lesenswert sind, schon eher.
Darin liegt vielleicht das Paradox. KI könnte manches, was Verlage traditionell geleistet haben, entwerten und zugleich eine ihrer ältesten Tätigkeiten aufwerten: das Urteilen.
Was verdient Aufmerksamkeit? Wofür können wir einstehen? Was verdient Vertrauen?
Damit bin ich wieder bei der Frage, die ich mir zu KI und Verlagswesen immer wieder stelle: Wenn Inhalte praktisch unbegrenzt verfügbar werden, welches knappe Gut besitzt ein Verlag dann eigentlich?
Die Fähigkeit, noch mehr davon zu produzieren, ist es vermutlich nicht. Vielleicht ist es eine Kombination aus Urteil, Rechten, Beziehungen zum Publikum, Reputation und Vertrauen.
Ich halte das nicht für eine schlechte Nachricht für Verlage. Es könnte einen großartigen Verlag sogar wertvoller machen denn je. Aber nur, wenn wir aufhören, unseren Wert über die Fähigkeit zu definieren, etwas zu produzieren und zu vertreiben, das die Technologie nahezu unbegrenzt verfügbar macht.
Wertvoll ist der Verlag im KI-Zeitalter womöglich nicht, weil er Inhalte produzieren kann, sondern weil er Inhalte vertrauenswürdig machen kann.
Vielleicht sollten wir also nicht fragen: Wurde KI eingesetzt?
Vielleicht lautet die Frage eher: Wenn es nicht mehr knapp ist, Inhalte zu produzieren, was besitzen wir dann noch, das knapp ist?
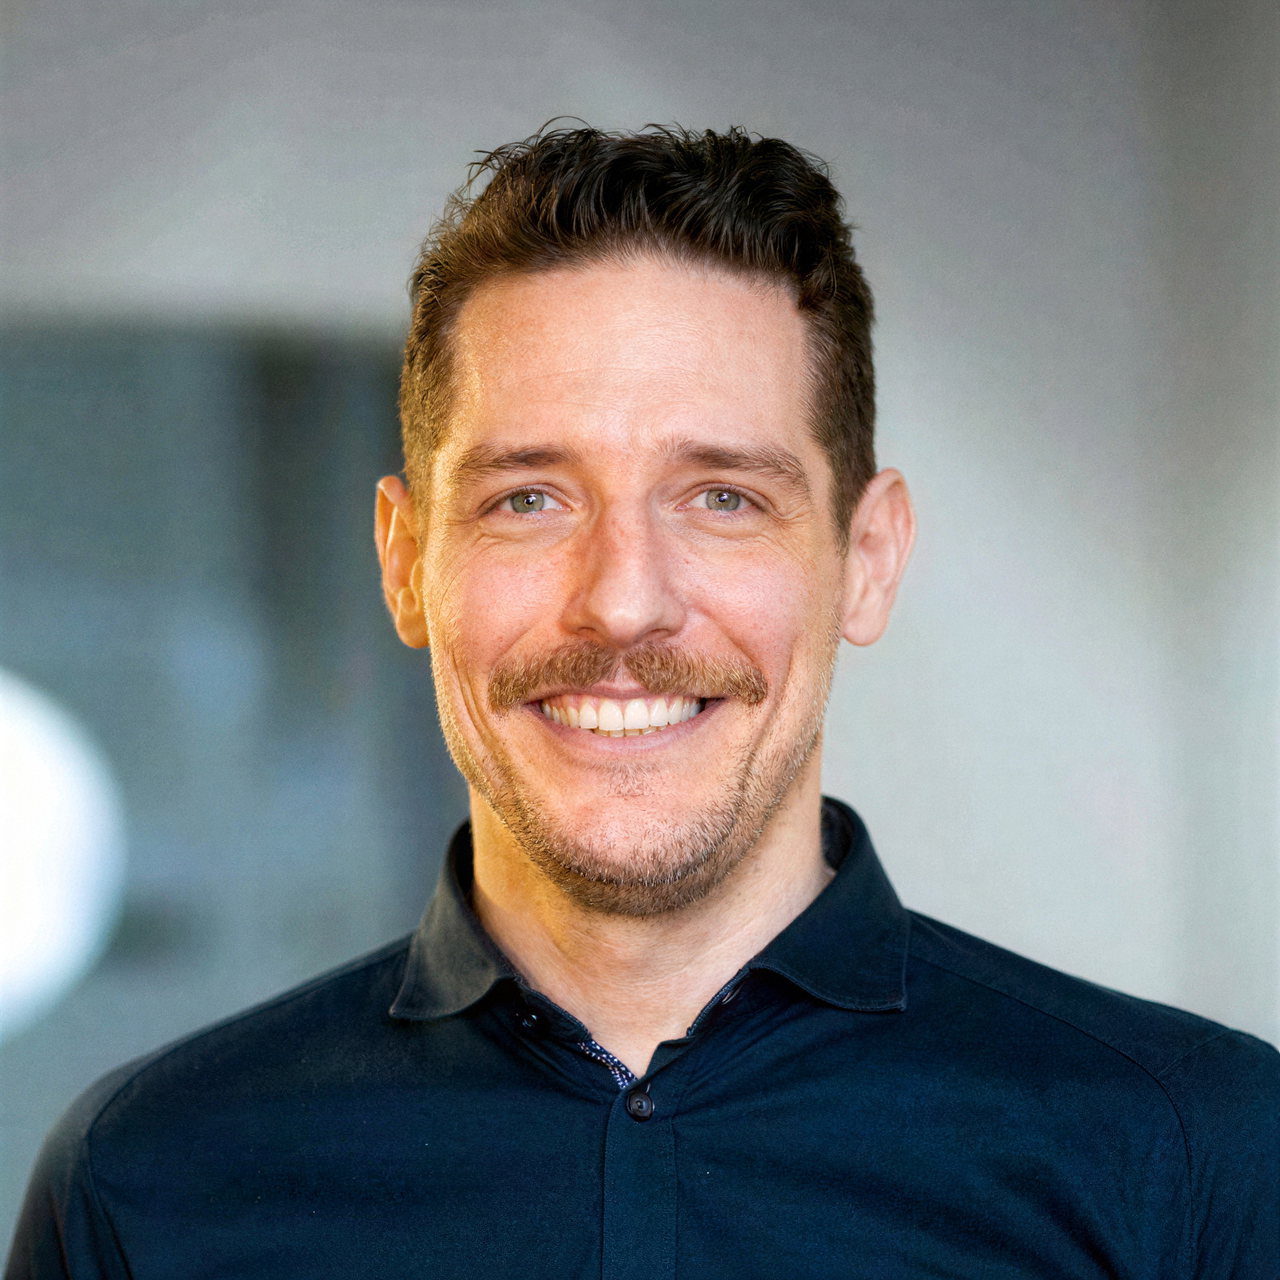
Sebastian Mayeres ist CEO von knk Software LP.
Sebastian arbeitet seit mehr als 23 Jahren mit Verlagen an den komplizierten, aber entscheidenden Themen hinter jeder Transformation: Systeme, Daten, Prozesse, Metadaten, Rechte, Honorare, CRM und ERP.
Also all das, was niemand auf eine Keynote-Folie schreibt, auf das sich aber alle verlassen, wenn sich das Geschäft bewegen muss.
Er begann in der Softwareentwicklung, wechselte dann in Beratung und Vertrieb und verbringt heute die meiste Zeit damit, Führungskräften in Verlagen zu helfen, aus operativer Komplexität bessere Entscheidungen zu machen.
Für Sebastian bedeutet Transformation nicht, dem nächsten Hype-Tool hinterherzulaufen.
Es geht darum, ein Unternehmen aufzubauen, das weiß, was es tut, warum es das tut und was sich als Nächstes ändern muss.